


Hundert kostenlose Events am Tag, und das Beste verpasse ich
Das Beste in Berlin passiert 300 Meter von meiner Tür, und ich erfahre zu spät davon, oder nie. Das Chorkonzert im Hof der Bibliothek nebenan zur Fête de la Musique, die Mieterberatung, der BSR-Kieztag, der neue Street-Food-Markt zwei Straßen weiter. Nicht die großen Festivals, die kriegt jeder mit, sondern die kleinen, lokalen Sachen, die leise an mir vorbeigehen.
Nicht, weil es nichts zu entdecken gäbe. Berlin hat jeden Tag rund hundert kostenlose Veranstaltungen, der Weg zur Information kostet nur zu viel. Wer spontan losziehen will, springt zwischen Event-Apps, Facebook-Gruppen und Kiezblogs, vergleicht, schätzt Entfernungen, arbeitet sich durch Kategorien. Am Ende steht selten eine Entscheidung, sondern Entscheidungsmüdigkeit. Und die endet mit „vielleicht später".
Die Ausgangsfrage des Projekts: Wie gestaltet man eine App, die Entscheidungen reduziert, statt sie nur schöner zu präsentieren?
Gebaut für Leute in Berlin, die spontan rauswollen, ohne zu planen, mich selbst eingeschlossen. Eine Lücke zwischen zwei Terminen, kein Vorlauf, keine Recherche, keine Anmeldung. Drei Situationen, in denen das zählt:
Erst ein Skript für mich selbst
Angefangen habe ich pragmatisch, weil es erst mal nur für mich gedacht war: ein Python-Skript, das täglich die Quellen scrapt, nach meinen Kategorien filtert und mir mittags eine Mail schickt. Irgendwann wollte ich das nicht nur im Postfach, sondern direkt vor Ort nutzen, unterwegs irgendwo in Berlin, und merkte: das könnte auch für andere interessant sein.
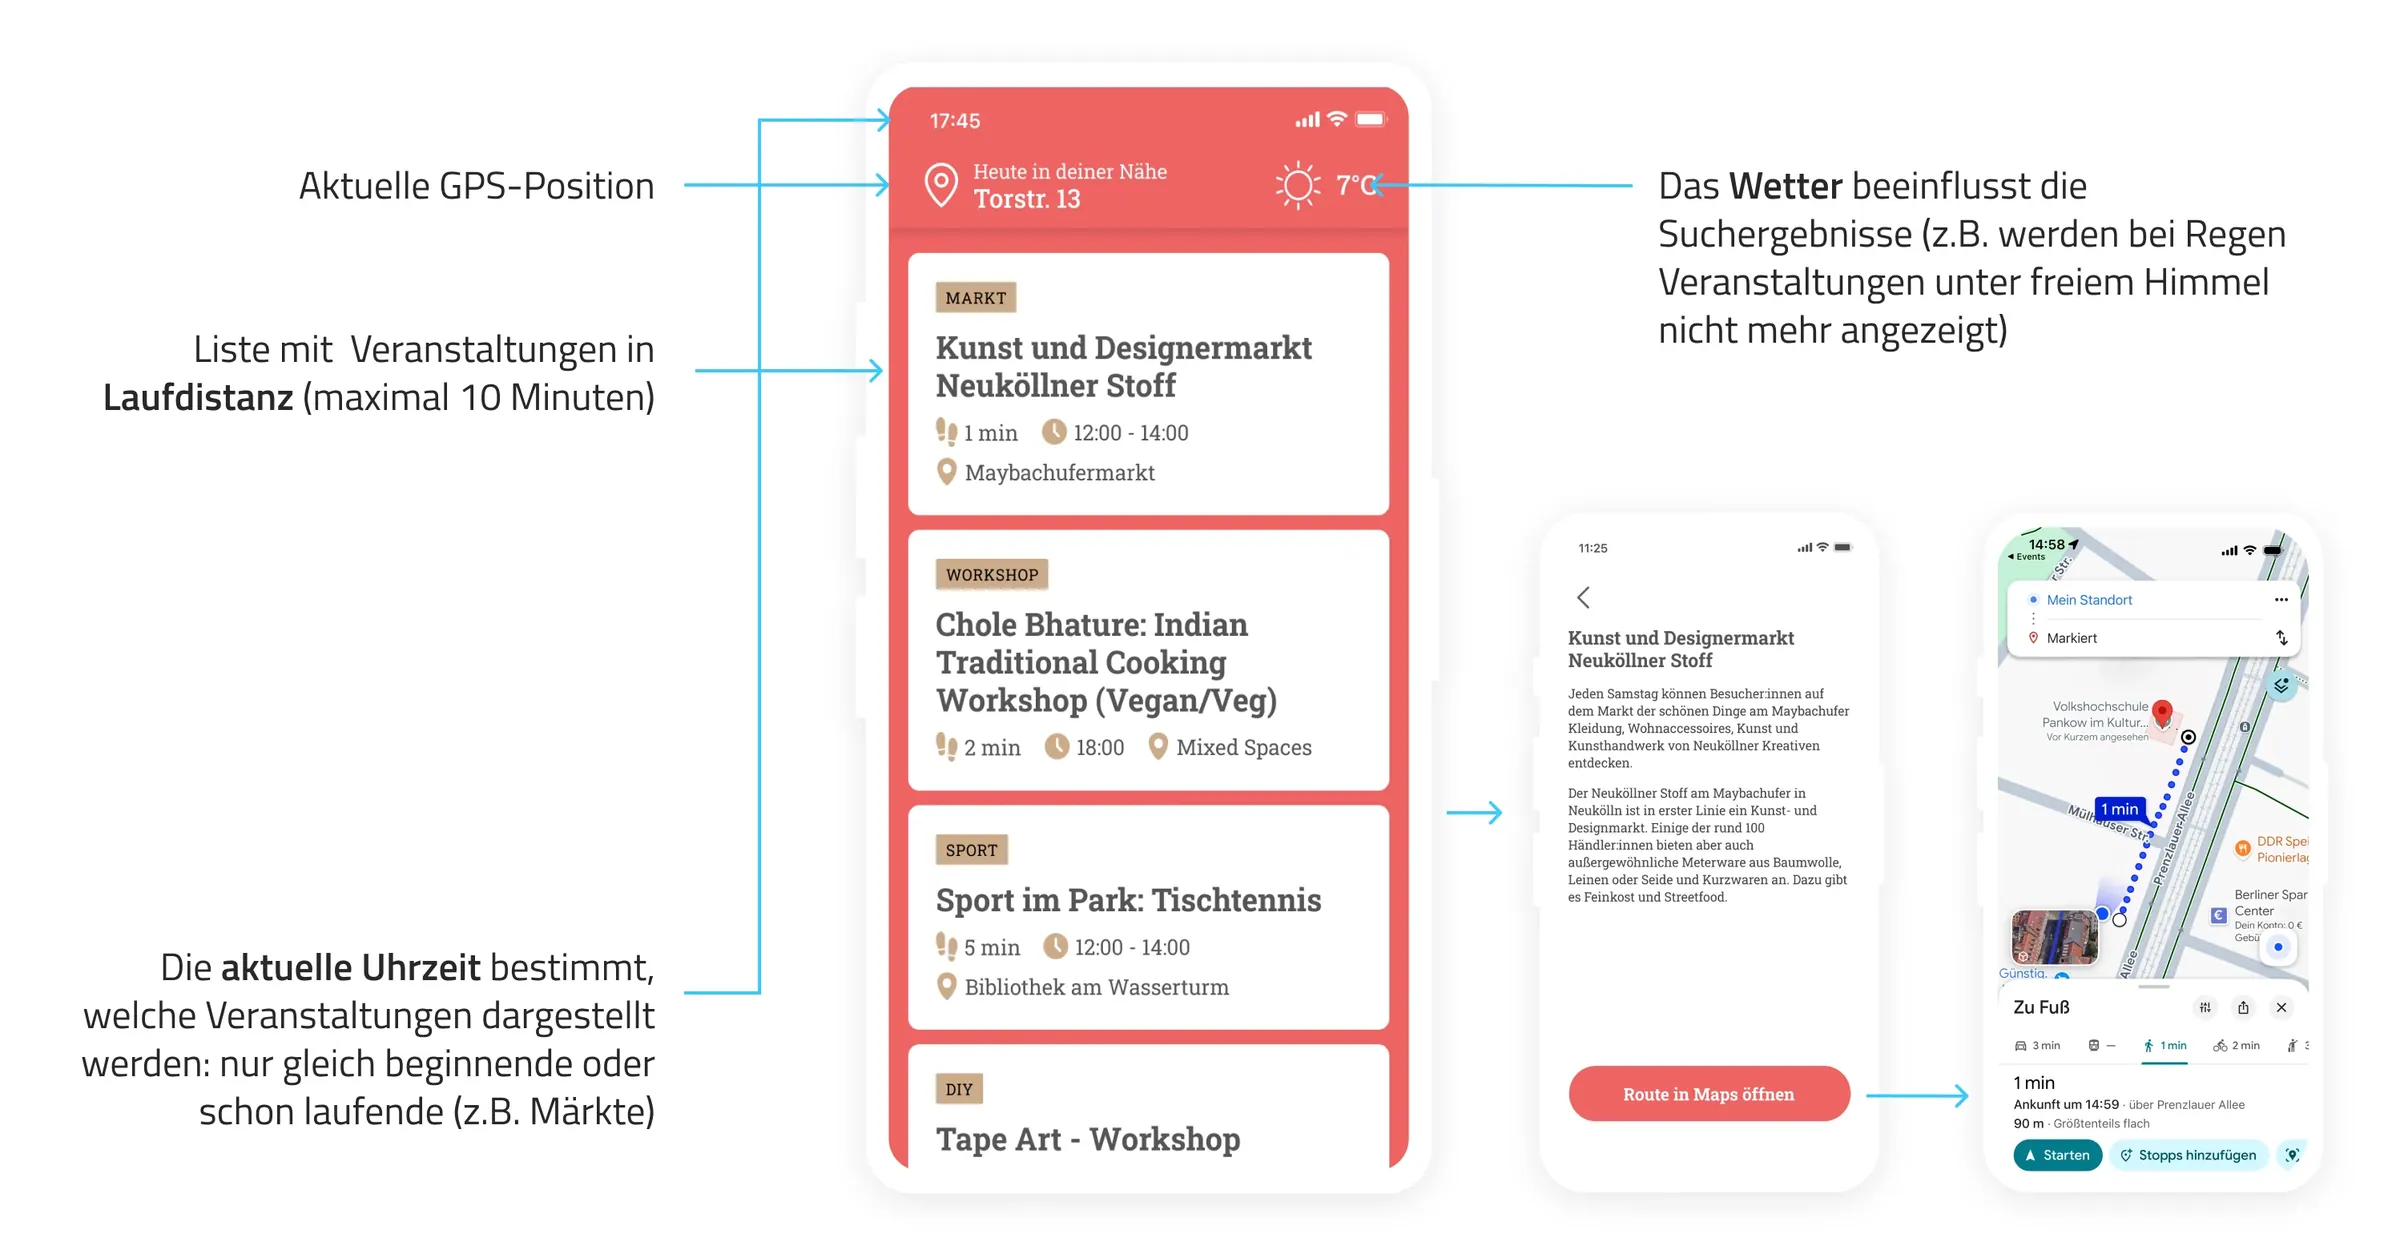
Das Smartphone kennt Standort und Uhrzeit, das Wetter dazu ist einen API-Aufruf entfernt. Diese drei Informationen reichen, um einen sinnvollen Feed zusammenzustellen.
Der Feed
Eine vertikale Liste von Karten, sortiert nach Laufdistanz. Jede Karte zeigt Event-Name, Kategorie, Laufzeit in Minuten und Startzeit. Über zehn Minuten Fußweg taucht ein Event gar nicht erst auf. Bei Regen werden Indoor-Events automatisch priorisiert.
Datenbasis
Der MVP bezieht Events von der Berliner Kulturdatenbank (freie API), berlin.de, radioeins und gratis-in-berlin.de und zeigt sie basierend auf GPS-Position oder einer vordefinierten Adresse. Standortdaten bleiben auf dem Gerät.
Tools und Zeitaufwand
Konzept und klickbarer Prototyp entstanden in einem Arbeitstag. Design in Figma, Prototyp als HTML/CSS.
Was noch fehlt
Die Daten sind oft unsauber, schlecht strukturiert, manchmal fehlen Informationen oder stimmen nicht. Ein verlässlicher Aggregator wäre ein eigenes Projekt für sich.
Bilder haben die Veranstaltungen meist keine. Das ist hier nicht schlimm, der Feed konzentriert sich aufs Wesentliche. Wichtiger wäre die Dichte: Es müssten mehr Events sein, damit in jedem Bezirk mindestens einer auftaucht. In der Innenstadt klappt das, in Zehlendorf wird es schon dünn.
Für einen kleinen Proof-of-Concept reicht das aber, und es funktioniert.
Häufig gestellte Fragen
Warum gibt es keine Suchleiste?
Weil Suche eine Entscheidung voraussetzt: Man muss wissen, wonach man sucht. Das Ziel dieses Konzepts war das Gegenteil – eine App, die relevante Vorschläge macht, ohne dass die Nutzerin aktiv suchen oder filtern muss. Die Kontextinformationen, die das Smartphone bereits kennt, ersetzen die Suchleiste.
Wie lange hat das Projekt gedauert?
Konzept und klickbarer Prototyp entstanden in einem Arbeitstag. Das Python-Skript, das als Vorgänger-Lösung diente, hatte ich vorab gebaut – es war der eigentliche Ausgangspunkt, auch wenn ich das damals noch nicht so gesehen habe.
Welche Tools wurden eingesetzt?
Python für das initiale Scraping-Skript und die E-Mail-Automation, Figma für das UI-Design und den interaktiven Prototypen, HTML/CSS für die klickbare Demo. Die Datenbasis stammt von gratis-in-berlin.de und der Berliner Kulturdatenbank.
Wäre das Konzept auf andere Städte übertragbar?
Prinzipiell ja – das Konzept basiert auf GPS, Uhrzeit und Wetter, nicht auf Berlin-spezifischen Daten. Es bräuchte eine verlässliche Event-Datenquelle für die jeweilige Stadt und User Research zum lokalen Verhalten: Was gilt in Hamburg als „laufbar"? Wie weit sind Menschen in München bereit spontan zu gehen?
Was wäre der nächste Schritt zur Produktreife?
Drei Dinge: Nutzertests in verschiedenen Berliner Kiezen mit echten spontanen Nutzungsszenarien, eine saubere Datenpipeline mit kurierter Eventquelle statt Scraping, und eine Entscheidung zum Business Model. Und vermutlich eine Antwort auf die soziale Frage – weil die eigentliche Hürde Motivation sein könnte, nicht Information.